
Autenticación y autorización en microservicios: OAuth 2.1, OpenID Connect y equivalencias Keycloak ↔ Entra ID
Los conceptos que necesitas antes de proteger tus APIs en .NET
Proteger una API parece sencillo hasta que aparecen las preguntas de verdad: ¿quién emite los tokens?, ¿cómo sabe mi servicio que un token es válido?, ¿qué diferencia hay entre un scope y un rol?, ¿por qué un token que funciona en un servicio no debería funcionar en otro?
Este artículo reúne los conceptos que necesitas para responderlas. No hay laboratorio: es la base sobre la que se apoyan los siguientes posts, donde aplicaremos todo esto con Keycloak y con Microsoft Entra ID para proteger un MCP Server en .NET. Todo lo que verás aquí vale igual para cualquier API REST o microservicio.
Autenticación y autorización
Son dos preguntas distintas que solemos mezclar:
- Autenticación: ¿quién eres? Comprobar la identidad de un usuario o de una aplicación.
- Autorización: ¿qué puedes hacer? Decidir si esa identidad tiene permiso para una operación concreta.
Un usuario puede estar perfectamente autenticado y, aun así, no tener permiso para borrar un pedido. En una arquitectura de microservicios, además, la identidad no siempre es una persona: muchas llamadas las hace un servicio a otro, sin ningún usuario de por medio.
OAuth 2.1 y OpenID Connect
Son los dos estándares sobre los que se construye casi todo lo demás:
- OAuth es un protocolo de autorización delegada. Permite que una aplicación obtenga acceso limitado a un recurso, en nombre de un usuario o en su propio nombre, sin manejar sus credenciales. El resultado es un access token.
- OpenID Connect (OIDC) es una capa de identidad construida sobre OAuth. Añade un ID token que describe quién es el usuario que ha iniciado sesión, y un mecanismo estándar de descubrimiento.
OAuth 2.1 no es un protocolo nuevo. Es una consolidación de OAuth 2.0 que recoge las buenas prácticas acumuladas durante años y elimina lo que resultó inseguro:
- PKCE es obligatorio en el flujo de código de autorización. La única excepción son clients confidenciales que ya usen el
noncede OpenID Connect para la misma protección, y siempre de forma consistente. - Desaparece el flujo implícito, que devolvía tokens directamente en la URL.
- Desaparece el flujo de contraseña del usuario, en el que la aplicación recogía usuario y contraseña.
- Las redirect URIs deben coincidir exactamente con las registradas.
En el momento de escribir este artículo, OAuth 2.1 sigue siendo un borrador del IETF, pero sus recomendaciones ya son la práctica habitual en las plataformas de identidad modernas.
Los cuatro actores
Todo intercambio OAuth involucra a cuatro actores:
- Resource owner (propietario del recurso): normalmente, el usuario.
- Client: la aplicación que quiere acceder al recurso. Puede ser una SPA, una aplicación de escritorio, una herramienta como Visual Studio Code u otro microservicio.
- Authorization server: quien autentica y emite los tokens. Keycloak y Entra ID cumplen este papel.
- Resource server: la API que protege los recursos y valida los tokens. En nuestro caso, cada microservicio.


La flecha discontinua es importante: el resource server no llama al authorization server en cada petición. Descarga sus claves públicas una vez y, a partir de ahí, valida los tokens por su cuenta.
Tokens
Los tres tipos
- Access token: el que se envía a la API, en la cabecera
Authorization: Bearer <token>. Es lo que autoriza la llamada. Tiene una vida corta, normalmente de minutos. - ID token: describe al usuario que ha iniciado sesión. Es para el client, no para la API. Nunca debe usarse para llamar a una API.
- Refresh token: permite al client obtener un nuevo access token cuando caduca el anterior, sin volver a pedir login al usuario.
Anatomía de un JWT
Los access tokens suelen ser JWT (JSON Web Token): tres bloques en Base64URL separados por puntos.
header.payload.signature
- Header: el algoritmo de firma y el identificador de la clave (
kid) usada para firmar. - Payload: los claims, es decir, la información del token.
- Signature: la firma del authorization server sobre los dos bloques anteriores.
El payload no está cifrado, solo codificado: cualquiera puede leerlo. Lo que no se puede es modificarlo sin invalidar la firma. Por eso nunca debe contener secretos.
Un payload típico:
{
  "iss": "https://auth.example.com/realms/demo",
  "aud": "orders-api",
  "sub": "f3a1c2d4-...",
  "azp": "web-app",
  "exp": 1790000000,
  "iat": 1789999700,
  "scope": "orders.read",
  "roles": ["Orders.Admin"]
}
Los claims que importan
| Claim | Significado |
|---|---|
iss |
Issuer: quién emitió el token. Debe coincidir con el authorization server en el que confías. |
aud |
Audience: para quién se emitió. Debe ser tu API. |
sub |
Subject: el identificador del usuario (o de la aplicación, en tokens sin usuario). |
azp |
Authorized party: el client que pidió el token. |
exp / iat |
Caducidad y momento de emisión. |
scope / scp |
Los scopes concedidos (el nombre del claim depende del proveedor). |
roles |
Los roles asignados (el formato depende del proveedor). |
Cómo se valida un token
Una API que recibe un token debe comprobar, en este orden:
- La firma, con las claves públicas del authorization server. Las publica en un documento llamado JWKS (JSON Web Key Set), y el
kiddel header indica cuál usar. - El issuer (
iss): que lo emitió el authorization server esperado. - La audiencia (
aud): que se emitió para esta API. - La vigencia (
exp): que no ha caducado. - Los permisos: scopes o roles, según la operación.
En ASP.NET Core, el middleware de JWT Bearer hace los cuatro primeros pasos por ti, siempre que le indiques la Authority y la Audience. El quinto lo decides tú con políticas de autorización.
Por qué la audiencia es crítica
En un entorno de microservicios, todos los servicios suelen confiar en el mismo authorization server. Si una API solo validara la firma y el issuer, aceptaría cualquier token de ese servidor, incluido uno emitido para otro servicio.
El escenario es fácil de imaginar: un servicio poco crítico recibe tokens de los usuarios. Si alguien lo compromete, podría reutilizar esos tokens contra el servicio de pagos. Validar la audiencia lo impide, porque cada token solo sirve para el servicio al que va dirigido.
Clients
Públicos y confidenciales
- Client confidencial: puede guardar un secreto de forma segura. Es el caso de un backend o de otro microservicio. Se autentica ante el authorization server con un client secret o, mejor, con un certificado.
- Client público: no puede guardar secretos. Una SPA, una aplicación móvil o una herramienta de escritorio distribuyen su código a los usuarios, y cualquier secreto incrustado acabaría expuesto. Por eso usan PKCE en lugar de secreto.
Redirect URIs
En el flujo con usuario, el authorization server devuelve al usuario a la aplicación mediante una redirect URI. Debe estar registrada de antemano y coincidir exactamente, carácter a carácter. Si no, el authorization server rechaza la petición. Hay una excepción: en aplicaciones nativas que usan una redirect URI de loopback (http://127.0.0.1), el puerto puede variar, porque lo elige la aplicación al arrancar.
Esta comparación estricta evita que un atacante redirija el código de autorización a una URL que controla. En el laboratorio con Keycloak veremos que es también una fuente habitual de errores.
Flujos
OAuth 2.1 deja dos flujos principales, uno para cada tipo de llamada.
Authorization code + PKCE: cuando hay un usuario
Es el flujo para cualquier aplicación que actúa en nombre de un usuario:
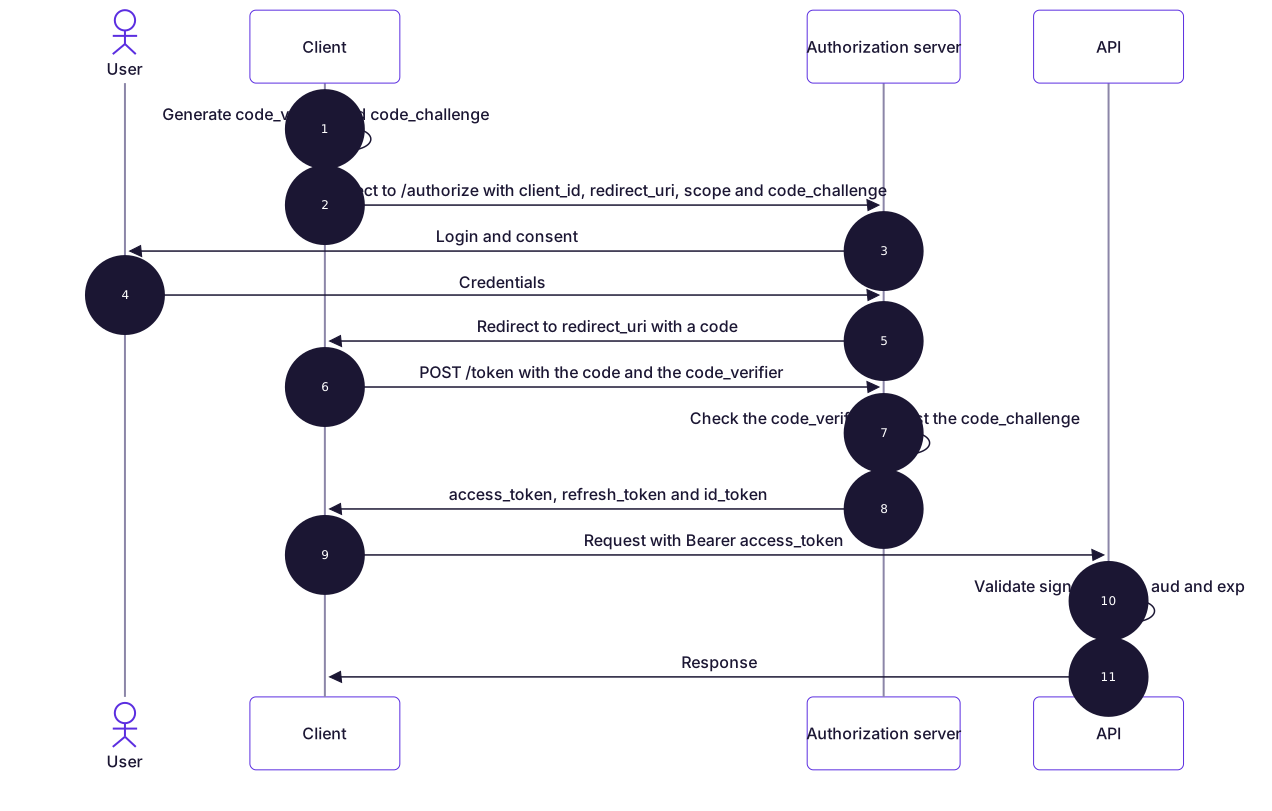
PKCE (Proof Key for Code Exchange) resuelve un problema concreto: el código de autorización viaja por el navegador y podría ser interceptado. Para evitar que sirva de algo, el client genera al inicio un valor aleatorio, el code_verifier, y envía solo su hash, el code_challenge. Al canjear el código por el token, debe presentar el code_verifier original. Quien intercepte el código no lo tiene, así que no puede canjearlo.
Client credentials: cuando no hay usuario
Es el flujo entre servicios. La aplicación se autentica con sus propias credenciales y recibe un token a su nombre:
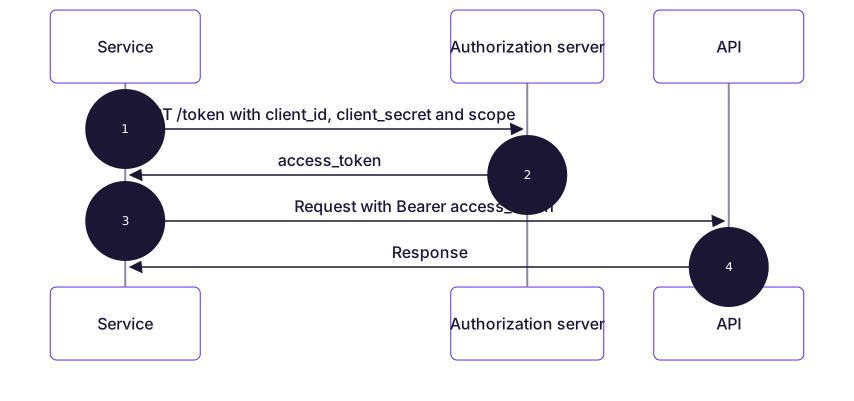
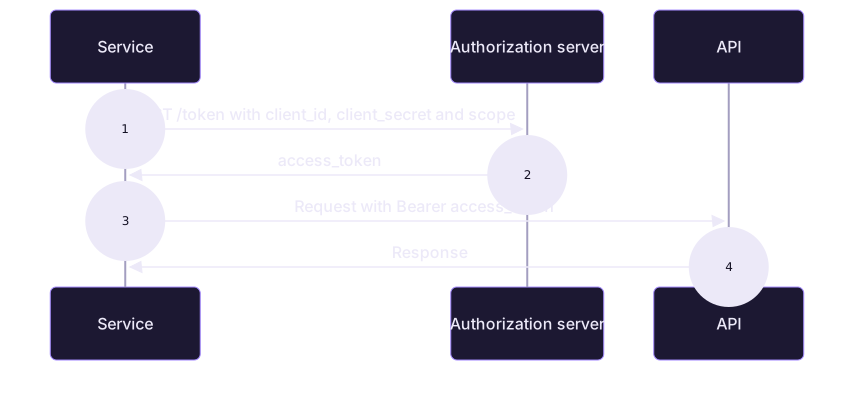
Es lo habitual para jobs, procesos programados y comunicación entre microservicios cuando la operación no depende de ningún usuario.
Permisos: scopes y roles
Los dos expresan permisos, pero representan cosas distintas:
- Scopes (permisos delegados): lo que el usuario permite que la aplicación haga en su nombre. Aparecen en las pantallas de consentimiento (“esta aplicación quiere leer tus pedidos”). El permiso efectivo es la intersección entre lo que el usuario puede hacer y lo que ha delegado.
- Roles (permisos de aplicación o de usuario): lo que una identidad tiene asignado. En el flujo de client credentials no hay usuario que delegue nada, así que los permisos se expresan con roles asignados a la propia aplicación.
Una regla práctica: si hay un usuario detrás, piensa en scopes, y combínalos con roles cuando necesites distinguir qué puede hacer cada usuario. Si no hay usuario, usa roles.
Descubrimiento
Configurar a mano todas las URLs de un authorization server sería frágil. Por eso publican un documento de descubrimiento, con sus endpoints, sus claves y sus capacidades:
- OpenID Connect Discovery: en
/.well-known/openid-configuration. - Authorization Server Metadata (RFC 8414): el equivalente en OAuth, en
/.well-known/oauth-authorization-server.
Con el issuer basta: tanto el middleware de .NET como los clients obtienen de ahí el endpoint de tokens, el de autorización y el JWKS.
Existe también el documento equivalente para el resource server, los Protected Resource Metadata (RFC 9728). La API publica qué authorization servers acepta y qué scopes soporta. Lo veremos en acción en el apartado de MCP.
Identidad entre microservicios
Cuando un servicio llama a otro, hay que decidir con qué identidad lo hace:
- Con la identidad del propio servicio, mediante client credentials. Es la opción más simple, pero el servicio de destino no sabe qué usuario originó la operación.
- Con la identidad del usuario, mediante un intercambio de token (RFC 8693): el servicio entrega el token que recibió y obtiene uno nuevo, emitido para el servicio de destino. Entra ID no implementa este RFC, pero ofrece el mismo patrón con su flujo On-Behalf-Of (OBO).
Lo que no se debe hacer es reenviar el token recibido tal cual. Ese token tiene como audiencia el primer servicio y, si el segundo lo acepta, está renunciando a validar la audiencia, con el problema que vimos antes.
Equivalencias entre Keycloak y Entra ID
Los dos proveedores implementan los mismos estándares, pero con nombres y modelos distintos. Esta es la tabla que usaremos en los siguientes laboratorios:
| Concepto | Keycloak | Entra ID |
|---|---|---|
| Espacio aislado de identidades | Realm | Tenant |
| Registro de una aplicación | Client | App registration |
| Identidad de una aplicación en el flujo sin usuario | Service account del client | Service principal (enterprise application) |
| Permiso delegado | Client scope | Scope definido en Expose an API |
| Permiso de aplicación | Client role (o realm role) | App role |
Identificador de la API en aud |
Se añade con un audience mapper | Lo asigna la plataforma (Application ID URI o client ID, según la versión del token) |
| Claim de scopes | scope (separados por espacios) |
scp (separados por espacios) |
| Claim de roles | resource_access.<client>.roles y realm_access.roles |
roles |
| Personalizar claims | Mappers | Optional claims y claims mapping |
| Descubrimiento | /realms/<realm>/.well-known/openid-configuration |
https://login.microsoftonline.com/<tenant>/v2.0/.well-known/openid-configuration |
| Identidades sin secretos para cargas de trabajo | Federated client authentication (service accounts de Kubernetes o SPIFFE) | Managed identities y workload identity federation |
| Despliegue | Autogestionado (contenedor, Kubernetes…) | Servicio gestionado de Microsoft |
Algunas diferencias que conviene tener presentes desde ya:
- La audiencia: en Keycloak hay que configurarla de forma explícita. En Entra ID la pone la plataforma, pero su valor cambia según la versión de token configurada en la aplicación.
- Los roles: Keycloak los anida en una estructura propia, y en .NET habrá que traducirlos a roles que el framework entienda. Entra ID los entrega en un claim
rolesplano. - El consentimiento: en Entra ID, los permisos de aplicación necesitan el consentimiento de un administrador del tenant.
- El coste: Keycloak es open source y lo despliegas y mantienes tú. Entra ID es un servicio gestionado, y su nivel gratuito cubre los flujos que usaremos.
Y en MCP…
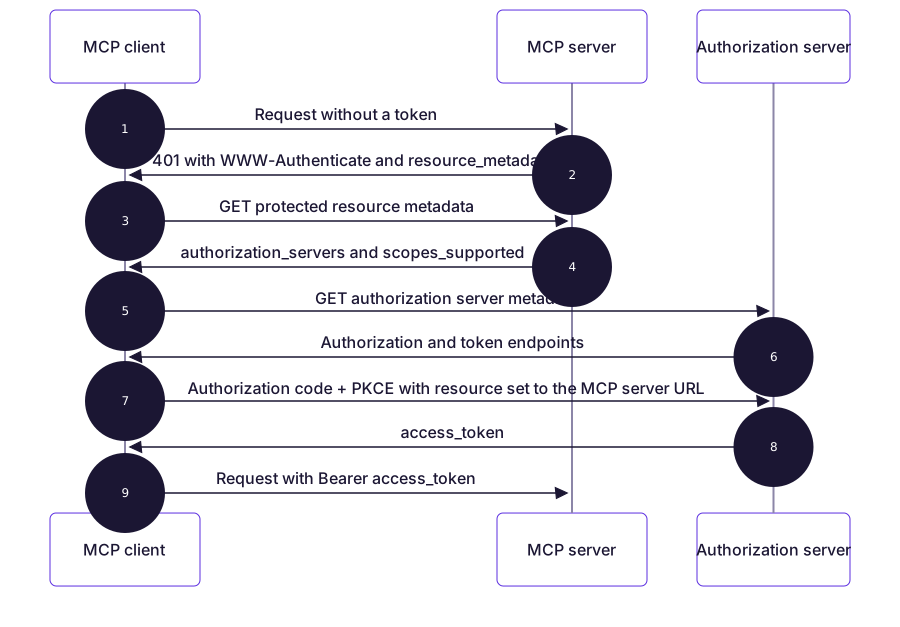
El Model Context Protocol define su autorización sobre estos mismos estándares para el transporte HTTP. La autorización es opcional en la especificación, pero, si se implementa sobre HTTP, debería seguir este modelo. Un MCP Server es un resource server más, con tres particularidades:
1. Descubrimiento automático. Un cliente MCP no necesita conocer de antemano el authorization server. Lo descubre a partir del propio servidor:
2. Tokens vinculados al servidor. El cliente indica para qué servidor quiere el token con el parámetro resource (RFC 8707), y el servidor debe rechazar los tokens que no se emitieron para él. Tampoco puede reenviar a otras APIs el token que recibe: es justo el problema de la audiencia que vimos en el apartado de microservicios.
3. Registro de clients. Un cliente MCP puede conectarse a servidores que no conocía, así que necesita obtener un client_id en cada authorization server. La especificación ha ido evolucionando y hoy establece este orden de preferencia:
- Credenciales registradas previamente: el
client_idse configura a mano. Es lo que haremos en los laboratorios. - Client ID Metadata Documents (CIMD): el
client_ides una URL que apunta a un JSON publicado por el propio cliente, con su nombre y sus redirect URIs. El authorization server lo descarga y lo valida. - Registro dinámico (RFC 7591): el cliente se da de alta solo en el authorization server. La revisión 2026-07-28 de la especificación lo marca como obsoleto en favor de CIMD, aunque sigue disponible por compatibilidad.
- Pedir los datos al usuario, como último recurso.
Todo esto lo pondremos en práctica en los siguientes artículos.
Qué viene
- Laboratorio con Keycloak: desplegaremos Keycloak en nuestro clúster de Kubernetes local, configuraremos realm, clients, scopes y roles, y protegeremos el MCP Server para usuarios (desde Visual Studio Code) y para aplicaciones.
- Laboratorio con Entra ID: el mismo escenario con el proveedor de identidad de Microsoft, y las diferencias que aparecen al cambiar de uno a otro.